- Technologie-Wandel: Fokus auf agentische Workflows und Computer Use statt reiner Chat-Abfragen.
- Compliance-Risiko: Bußgelder bei Verstößen gegen den EU AI Act von bis zu 7 % des weltweiten Jahresumsatzes möglich.
- Kosten-Struktur: Pay-per-Token Abrechnung erfordert striktes Caching und Modell-Routing zur Budgetkontrolle.
- Datenschutz: Abschluss eines AVV gemäß Art. 28 DSGVO für den Einsatz in Deutschland zwingend erforderlich.
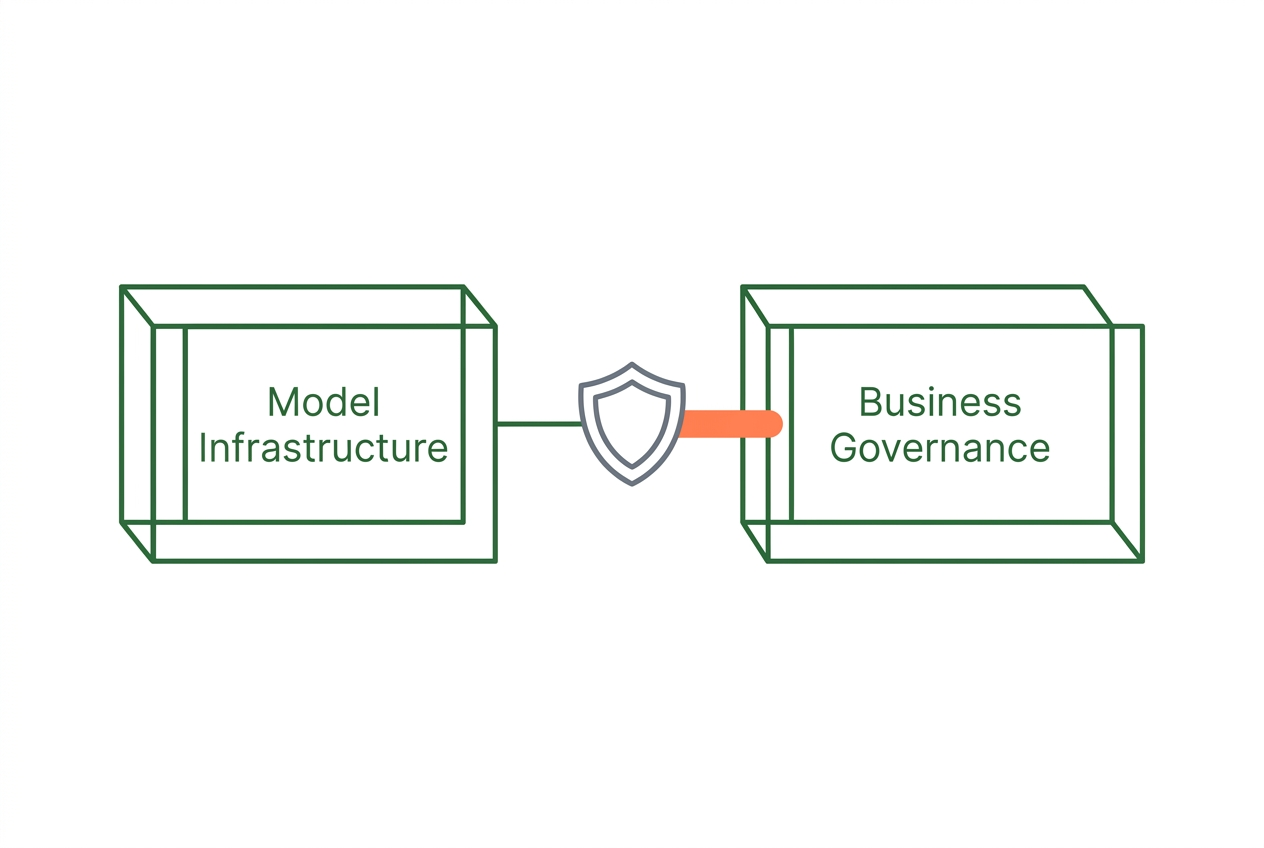
Die OpenAI API ermöglicht Unternehmen die Automatisierung komplexer Workflows durch GPT-Modelle, erfordert jedoch eine strikte Trennung zwischen Modell-Infrastruktur und betrieblicher Governance für Datensicherheit und Kosteneffizienz. Als Richtwert liegen die Token-Kosten je nach Modell und Volumen zwischen 0,002 und 15,00 Euro pro Million Token (eigene Einschätzung, Stand 05/2024). Dieser Artikel gehört zur Rubrik Webentwicklung auf webentwickler.pro und zeigt, wie Sie die GPT API für Unternehmen technisch stabil und rechtlich sauber in Ihre Systemlandschaft integrieren.
- Was leistet die OpenAI API für Unternehmen?
- Welche OpenAI API Use Cases passen zu KMU?
- Wie funktioniert OpenAI API Authentifizierung?
- In 6 Schritten zur ChatGPT API Integration
- Welche Kostenmodelle hat die OpenAI API?
- Welche Risiken hat eine Sprachmodell API?
- Wann lohnt sich GPT-4 API Zugang wirklich?
- Das nehmen Sie jetzt mit
Was leistet die OpenAI API für Unternehmen?
Die OpenAI API liefert Unternehmen Zugriff auf Sprachmodelle wie GPT-4, Sie senden Text rein, erhalten strukturierte Antworten zurück und automatisieren damit Textgenerierung, Klassifikation, Zusammenfassungen. Für den deutschen Mittelstand heißt das konkret: Kundenservice-Routinen, Content-Produktion, Datenauswertung, alles ohne eigene KI-Infrastruktur machbar. Die Kosten? Schlank: 0,002 bis 0,12 USD pro 1.000 Token. Ein typischer Support-Dialog mit 500 Token kostet rund 0,03 USD. Zum Vergleich, eine Vollzeitkraft für repetitive Textarbeit kostet etwa 3.500 EUR monatlich. Break-even erreichen Sie bei ungefähr 100.000 automatisierten Anfragen pro Monat. Das rechnet sich.
Die Praxis sieht so aus: E-Mail-Klassifikation (Anfragen nach Thema sortieren), Produktbeschreibungen aus Templates generieren, FAQ-Antworten vorschlagen, Rechnungsdaten aus Freitext extrahieren. Ein echtes Beispiel aus dem E-Commerce: Ein JTL-Shop mit 2.000 Artikeln braucht für SEO-Texte normalerweise 40 Stunden Redaktionsarbeit. Mit OpenAI API und einem maschinelles Lernen Mittelstand-Workflow in n8n? Vier Stunden Qualitätskontrolle reichen. Die API wirft Rohtexte aus, Sie checken Tonalität und Fakten. Aber, und das ist entscheidend, die Modelle arbeiten probabilistisch. Sie raten die nächstwahrscheinlichste Fortsetzung. Fachliche Korrektheit? Nicht garantiert. Rechtssichere Texte (Widerrufsbelehrung, Datenschutzerklärung) oder präzise Berechnungen (Staffelpreise, Steuerlogik), für die ist die API unbrauchbar.
Wo es eng wird: Echtzeitdaten existieren nicht, die Modelle kennen nur Trainingsdaten bis zu einem bestimmten Stichtag. Komplexe Workflows über mehrere Systeme (JTL-Wawi, Shopware, DATEV) werden schnell zur Sisyphusarbeit. Und dann die DSGVO-Realität: OpenAI verarbeitet auf US-Servern. Personenbezogene Daten? Sie brauchen einen Auftragsverarbeitungsvertrag und müssen Standardvertragsklauseln prüfen, ernst gemeint. Wer Kundennamen, E-Mail-Adressen oder Bestellhistorie einfach so an die API sendet, ohne Rechtsgrundlage zu dokumentieren, spielt Bußgeld-Roulette. Eine saubere Lösung trennt deshalb strikt: Metadaten (Bestellnummer, Produktkategorie) hier, Personendaten dort, und die API arbeitet nur mit anonymisierten Textbausteinen.
Welche OpenAI API Use Cases passen zu KMU?
Die Integration der OpenAI API bietet für kleine und mittlere Unternehmen (KMU) im eCommerce weit mehr als nur einfache Chatbots. Dieser Vergleich gehört zur Rubrik Workflow-Automatisierung auf webentwickler.pro und zeigt, wie Sie durch gezielte Anbindungen manuelle Prozesse in messbare Effizienz verwandeln. Während Standard-Plugins oft an starren Logiken scheitern, ermöglicht die API eine flexible Verarbeitung von Geschäftsdaten, sofern die Architektur, etwa durch agentische KI Automatisierung, sauber aufgesetzt ist.
| Anwendungsfall | Nutzen (ROI) | Technischer Aufwand | Risiko / DSGVO | Teamgröße |
|---|---|---|---|---|
| Kundenservice (RAG) | Hoch (70% Entlastung) | Mittel (Vektordatenbank) | Mittel (Anonymisierung) | 1 Entwickler |
| Content Operations | Mittel (Zeitgewinn) | Gering (Prompting) | Gering (Public Data) | 1 Redakteur |
| Lead-Qualifizierung | Hoch (Conversion +15%) | Mittel (CRM-Sync) | Hoch (Pll-Daten) | Dev + Sales |
| Workflow-Automatisierung | Sehr Hoch (Skalierung) | Hoch (n8n/Custom) | Mittel (Audit-Logs) | 1 Architekt |
Quelle der Methodik: OpenAI Business Resources, Offizieller Leitfaden zur Identifizierung und Skalierung von KI-Anwendungsfällen
Für deutsche Unternehmen ist die Einhaltung der DSGVO sowie eine strikte Rollentrennung zwischen KI-Assistenz und menschlicher Freigabe entscheidend. Bevor Sie vollautonome Prozesse skalieren, sollten Sie assistive Systeme mit klaren Quellenangaben und Konfidenzprüfungen implementieren. Dies reduziert das Risiko von Halluzinationen und sichert die Datenqualität in Ihren ERP- und CRM-Systemen.
Sie benötigen Unterstützung bei der Anbindung von KI-Modellen oder möchten produktive Automatisierungen im Mittelstand etablieren? Wir unterstützen Sie bei der technischen Umsetzung individueller Workflows.
Wie funktioniert OpenAI API Authentifizierung?
OpenAI API? Authentifizierung läuft über einen geheimen API-Schlüssel, Sie generieren ihn im Dashboard, schicken ihn bei jeder Anfrage als Bearer Token im HTTP-Header mit, fertig. Der Schlüssel identifiziert Ihr Projekt, regelt die Zugriffe und rechnet ab. Keine korrekte Authentifizierung? HTTP 401. Egal ob GPT-4, Embeddings oder Whisper. Technisch einfach: Header Authorization: Bearer sk-proj-... setzen, Zugriff kriegen. Die echte Arbeit fängt danach an, denn ein geleakter Key verbrennt Ihr Budget in Stunden. Oder offenbart sensible Prompts. Oder beides.
OpenAI hat drei Schlüsseltypen im Angebot: Project API Keys (das sollten Sie nehmen, auf ein Projekt beschränkt), User API Keys (veraltet, organisationsweit), Service Account Keys (für Roboter ohne Login). Für echte Shops und n8n-Workflows? Nur Project Keys. Sie können sie granular drosseln, auf einzelne Modelle, auf Rate Limits, auf IP-Ranges. Im Dashboard legen Sie fest: Dieser Key darf nur gpt-4o-mini für Produktbeschreibungen aufrufen. Nicht gpt-4. Nicht die teuren Modelle. Und maximal 100 Requests pro Minute. Ein kompromittierter Schlüssel räumt dann nicht Ihr ganzes Kontingent leer. Mehrere Umgebungen? Entwicklung, Staging, Produktion? Jede kriegt ihren eigenen Key. Falls was schiefgeht, widerrufen Sie gezielt, ohne alle Systeme zu lahmlegen.
Sichere Speicherung des Keys ist keine Empfehlung. Das Compliance-Pflicht nach DSGVO Artikel 32. Hardcoden Sie den Key nicht direkt im Code, const apiKey = "sk-proj-..." ist Wahnsinn. Ein Git-Commit, ein Error-Log, ein Support-Screenshot, weg ist er. Nutzen Sie Umgebungsvariablen. In Node.js laden Sie process.env.OPENAI_API_KEY aus einer .env-Datei, die im .gitignore steht. In n8n? Credential-Typ „OpenAI API“, n8n verschlüsselt das in der Datenbank, gibt es nie im Export preis. Production-Server? Umgebungsvariablen über Hetzner Cloud, AWS Systems Manager Parameter Store oder HashiCorp Vault. Niemals in einer Datei im Webroot. Ein geleakter Key kostet nicht nur Geld. Wenn ein Angreifer über Ihre API personenbezogene Daten verarbeitet, haften Sie nach DSGVO, ob Sie den Key selbst geleakt haben oder ein Entwickler ihn versehentlich committed hat, spielt keine Rolle.
Im DACH-Raum kommen drei Compliance-Punkte dazu, die über Authentifizierung hinausgehen. Erstens: OpenAI verarbeitet alle Prompts auf US-Servern. Sie brauchen einen Auftragsverarbeitungsvertrag (AVV) nach DSGVO Artikel 28, OpenAI stellt ihn seit 2023 im Dashboard bereit. Zweitens: Schicken Sie Kundennamen, E-Mails, Bestellhistorie in Prompts? Dann prüfen Sie, ob OpenAI das zum Training nutzt. Bei API-Nutzung ist das seit März 2023 standardmäßig aus. Bei ChatGPT Enterprise optional. Drittens: Ab August 2026 greift der EU AI Act Compliance 2026, für KI-Systeme mit „hohem Risiko“ (automatisierte Kreditentscheidungen, Bewerbungs-Scoring) brauchen Sie zusätzliche Dokumentation. Auch wenn Sie nur eine fremde API nutzen. Wer OpenAI in echten Shops einsetzt, dokumentiert im Code: Welche Daten gehen zur API? Wie lange Logs? Wer hat Zugriff auf die Keys? Ein README.md mit „API-Key in .env, wird nicht geloggt, AVV in /docs/compliance“ reicht oft aus, aber es muss da sein, bevor die Aufsichtsbehörde klingelt.
In 6 Schritten zur ChatGPT API Integration
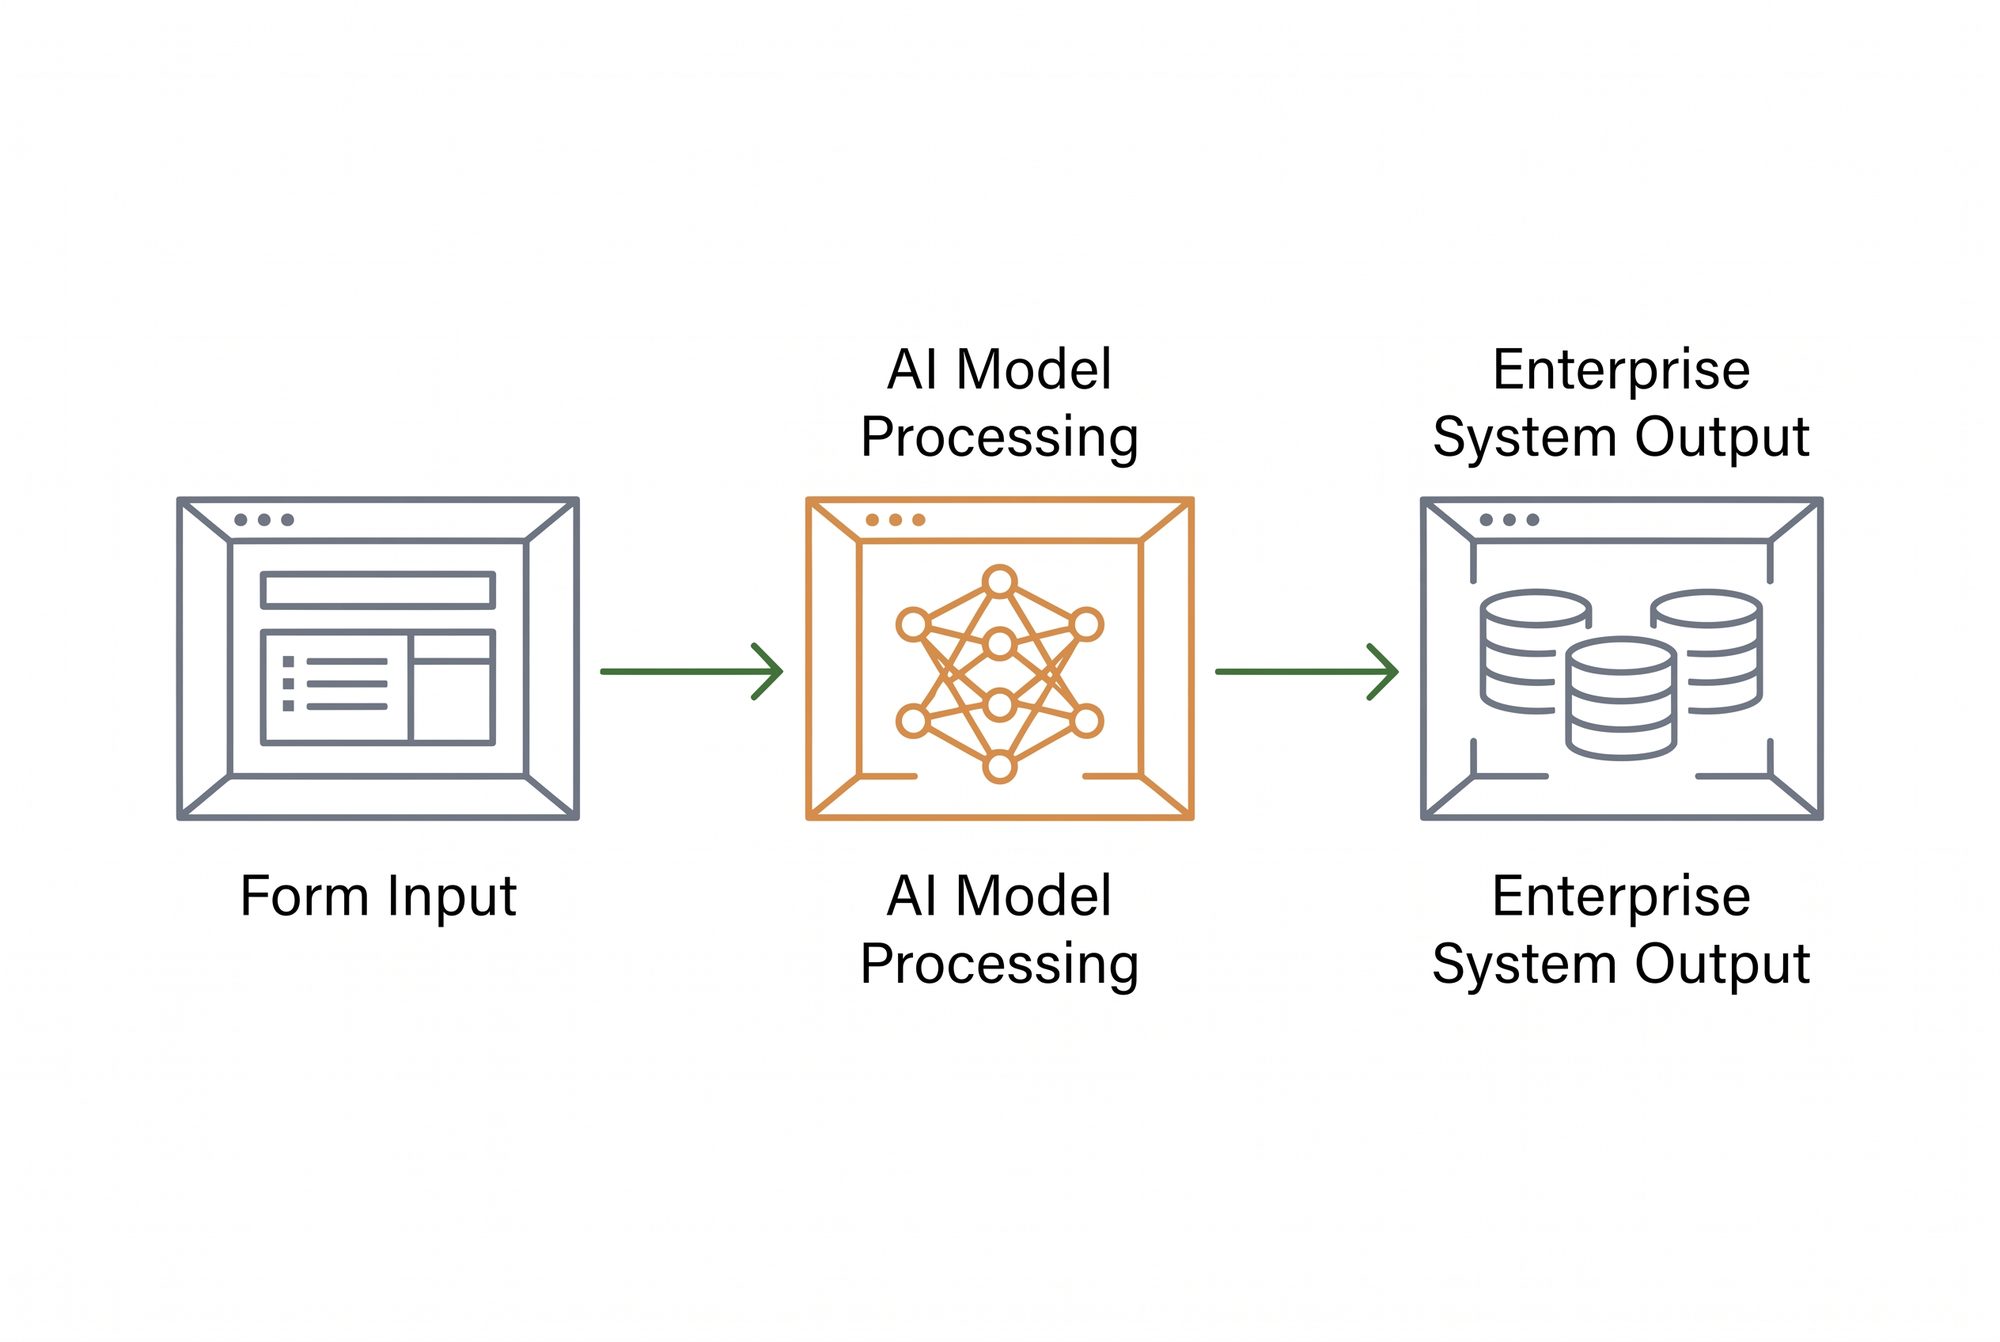
Die Integration der OpenAI-Schnittstelle in bestehende Shop-Systeme wie JTL oder Shopware erfordert eine strukturierte Herangehensweise, um technische Schulden und unnötige API-Kosten zu vermeiden. Dieser Prozess ist Teil der technischen Expertise auf webentwickler.pro und zeigt, wie Sie die ChatGPT API Integration stabil in Ihre Infrastruktur einbetten.
- Anwendungsfall und Zieldefinition festlegen. Identifizieren Sie präzise, welche Aufgabe die KI übernehmen soll, etwa die automatische Erstellung von Meta-Beschreibungen für 5.000 Artikel oder die Klassifizierung von Support-Tickets. Ohne klare Definition riskieren Sie „Prompt-Drift“ und unvorhersehbare Token-Kosten, die bei ineffizienter Nutzung schnell dreistellige Beträge pro Monat erreichen können.
- Technische Architektur und Tool-Wahl bestimmen. Entscheiden Sie, ob Sie die API direkt via PHP/TypeScript ansprechen oder eine Middleware wie n8n nutzen. Während fertige Plugins oft starr sind, ermöglicht agentische KI Automatisierung eine flexible Logik, die auch komplexe Fallback-Szenarien abdeckt, falls die API einmal verzögert antwortet.
- Prompt-Engineering und Prototyping im Playground. Testen Sie die System-Prompts direkt in der OpenAI-Konsole. Hier legen Sie fest, ob die KI als „erfahrener SEO-Texter“ oder „technischer Support-Mitarbeiter“ agiert. Ein schlecht optimierter Prompt kann die Antwortlänge und damit die Kosten um den Faktor 3 erhöhen, ohne die Qualität zu verbessern.
- Sicherheits- und Datenschutz-Layer einbauen. Da Sie im deutschen eCommerce agieren, müssen Sie sicherstellen, dass keine personenbezogenen Kundendaten ungefiltert an US-Server übertragen werden. Implementieren Sie eine Anonymisierungsschicht, die Namen oder Adressen entfernt, bevor der Request die API erreicht, um DSGVO-konform zu bleiben.
- Integration in die Shop-Workflows. Binden Sie die API-Aufrufe asynchron ein. Ein synchroner Aufruf während des Speicherns im Backend würde die Ladezeit massiv erhöhen. Nutzen Sie stattdessen Webhooks oder Message-Queues, damit Ihr JTL-Shop oder Shopware-Backend flüssig bedienbar bleibt, während die KI im Hintergrund arbeitet.
- Monitoring und Kostenkontrolle etablieren. Richten Sie Hard-Limits im OpenAI-Dashboard ein und loggen Sie die Qualität der Rückgabewerte. Da sich Modelle wie GPT-4o regelmäßig ändern, ist ein kontinuierliches Monitoring notwendig, um sicherzustellen, dass die generierten Texte weiterhin Ihren Qualitätsstandards entsprechen und keine „Halluzinationen“ in die Produktdatenbank gelangen.
Welche Kostenmodelle hat die OpenAI API?
Die Kostenstruktur der OpenAI API basiert primär auf einem Pay-as-you-go-Modell, bei dem die Abrechnung pro verarbeitetem Token erfolgt. Für KMU im deutschen E-Commerce ist es entscheidend, nicht nur die reinen Preise pro Million Token zu betrachten, sondern die Gesamtkosten pro erfolgreichem Ergebnis zu kalkulieren. Dieser Ansatz berücksichtigt neben Input- und Output-Kosten auch Faktoren wie Caching-Vorteile oder die Nutzung von Batch-Verarbeitungen zur Kostenreduktion. Um die OpenAI API Kosten senken zu können, sollten Sie technische Mechanismen wie Modell-Routing und strikte Output-Limits in Ihre Architektur integrieren.
| Kostenkomponente | Logik & Abrechnung | Optimierungshebel |
|---|---|---|
| Token-Verbrauch (Input/Output) | Nutzungsbasiert (Pay-as-you-go) | Strikte Begrenzung der Output-Länge; Vermeidung redundanter System-Prompts. |
| Modell-Wahl (GPT-4o vs. Mini) | Preisdifferenz je nach Leistung | Modell-Routing: Einfache Aufgaben an kleinere, günstigere Modelle delegieren. |
| Batch-Verarbeitung | Bis zu 50% Rabatt möglich | Zeitversetzte Verarbeitung für nicht-kritische Workflows (z. B. Produktbeschreibungen). |
| Governance & Compliance | Fixkosten / Zeitaufwand | Einplanung von Kosten für DSGVO-Prüfung, Logging und rechtliche Absicherung. |
| Budget-Sicherung | Plattform-Limits | Einrichtung von Hard-Limits im OpenAI Dashboard und anwendungsspezifische Sperren. |
Quelle der Preisdaten: OpenAI API Documentation, Offizielle Preisstruktur und Erläuterung der Token-basierten Abrechnung sowie Batch-Optionen.
Welche Risiken hat eine Sprachmodell API?
Sprachmodell-APIs in deutschen Unternehmen sind eine tickende Zeitbombe: Datenschutzverletzungen, Halluzinationen, Prompt Injections und Vendor Lock-in warten auf jeden, der die Architektur nicht von Grund auf absichert. Machine Learning APIs in Deutschland produktiv einzusetzen bedeutet: PII-Transfer kontrollieren, Halluzinationen ausmerzen, Prompt Injection blocken, EU AI Act erfüllen. Nicht irgendwann. Jetzt. Dieser Artikel aus der Rubrik webentwicklung auf webentwickler.pro zeigt Ihnen die realen Bruchstellen, und wie Sie diese mit technischen und vertraglichen Maßnahmen dicht machen.
Das größte technische Risiko? Halluzination. Sprachmodelle erfinden plausible Antworten. Einfach so. Falsch, aber überzeugend. Im Kundensupport bedeutet das: falsche Preise, fehlerhafte Lieferbedingungen, rechtlich fragwürdige Aussagen, ohne dass ein Mensch eingreift. Eine RAG-Architektur ist hier Ihre Rettung. Sie binden das Modell an eine eigene Wissensdatenbank (Produktkatalog, FAQ, Verträge) und erzwingen, dass jede Antwort auf eine verifizierbare Quelle verweist. Ohne RAG? Halluzination bleibt unkontrollierbar, rechtlich und wirtschaftlich ruinös.
Risiko Nummer zwei: PII-Transfer. Kundendaten (Namen, E-Mail-Adressen, Bestellhistorie) verlassen Ihre Infrastruktur. Landen in Rechenzentren außerhalb der EU. Das ist nicht nur ein technisches Problem, es ist ein Compliance-Desaster. KPMG warnt: Der EU AI Act verlangt bei Hochrisiko-Anwendungen eine detaillierte Risikoanalyse, besonders bei grenzüberschreitendem Datenfluss. Lösung: Eine unternehmenseigene Gateway-Schicht. Sie maskiert personenbezogene Daten vor der Übertragung, Namen werden Pseudonyme, E-Mail-Adressen werden Hashes, Bestellnummern werden anonymisierte IDs. Die API bekommt nur, was sie braucht. Kein DSGVO-Verstoß. Kein EU AI Act Compliance 2026-Problem. Ohne Gateway-Schicht? Das ist ein offenes Haftungsrisiko, das Sie nicht auf den API-Anbieter abwälzen können.
Risiko drei: Prompt Injection. Ein Angreifer manipuliert die Eingabe, das Modell ignoriert seine internen Anweisungen, vertrauliche Daten landen beim Gegner. In Agenten-Systemen mit Datenbank- oder API-Zugriff führt das zu Datenlecks oder unautorisierten Transaktionen. Das Least-Privilege-Prinzip schließt diese Lücke: Der Agent bekommt nur die minimal notwendigen Rechte (Lesezugriff auf Produktdaten, kein Schreibzugriff auf Kundendaten). Jeder API-Call wird protokolliert. Eine strikte Input-Validierung filtert verdächtige Muster, bevor sie das Modell erreichen. Ohne diese Maßnahmen? Prompt Injection bleibt ein Angriffsvektor, und den schließt man nur durch Architektur, nicht durch Verträge.
Risiko vier: Vendor Lock-in. Sie bauen Ihre Workflows direkt auf eine API auf, und sind dann abhängig. Preiserhöhungen, API-Änderungen, Serviceausfälle: alles trifft Sie hart. Eine Abstraktionsschicht (eigene API-Wrapper, standardisierte Prompt-Templates) ermöglicht den Wechsel zwischen Anbietern ohne Neuentwicklung. Vertraglich sichern Sie ab: Datenresidenz in der EU, AVV nach Art. 28 DSGVO, klare SLAs. Bei Hochrisiko-Anwendungen (automatisierte Kreditentscheidungen, medizinische Beratung) fordert der EU AI Act zwingend menschliche Aufsicht und dokumentierte Governance. Keine API-Integration ohne Prüfprozess.
Wann lohnt sich GPT-4 API Zugang wirklich?
GPT-4 API rentiert sich, wenn Sie wiederkehrende Textaufgaben mit hohen Qualitätsansprüchen automatisieren, komplexe Datenstrukturen verarbeiten oder mehrsprachige Inhalte generieren, und die Token-Kosten unter den Personalkosten für manuelle Bearbeitung liegen. Für einfache Klassifikationen, Keyword-Extraktion oder Sentiment-Analyse reichen oft günstigere Modelle wie GPT-3.5 Turbo oder spezialisierte Open-Source-Alternativen aus. Die Entscheidung fällt auf Basis von drei Faktoren: Aufgabenkomplexität, Fehlertoleranz und Verarbeitungsvolumen. Ein konkretes Beispiel: 500 Produktbeschreibungen mit technischen Spezifikationen und SEO-Anforderungen kosten mit GPT-4 etwa 15–25 EUR pro Batch (abhängig von der Prompt-Länge), während GPT-3.5 Turbo bei 3–5 EUR liegt, aber die Nachbearbeitung bei GPT-3.5 verschlingt 2–3 Stunden Arbeitszeit, die bei GPT-4 entfallen.
Dieser Artikel gehört zur Rubrik maschinelles Lernen Mittelstand auf webentwickler.pro und zeigt, wie Sie KI-Modelle-APIs wirtschaftlich sinnvoll in bestehende Workflows integrieren. Die zentrale Frage lautet nicht „Welches Modell ist das beste“, sondern „Welches Modell löst meine Aufgabe mit dem besten Kosten-Nutzen-Verhältnis“ GPT-4 liefert bei komplexem Reasoning, mehrstufigen Anweisungen und kontextabhängiger Textgenerierung messbar bessere Ergebnisse als kleinere Modelle, aber nur, wenn Ihre Aufgabe diese Fähigkeiten wirklich braucht. Für strukturierte Datenextraktion aus Rechnungen, einfache Chatbot-Antworten oder Kategorisierung von Support-Tickets sind spezialisierte Modelle oder Fine-Tuned Varianten von GPT-3.5 oft die wirtschaftlichere Wahl.
Ein reales Szenario: Sie betreiben einen JTL-Shop mit 1.200 Artikeln und wollen automatisiert Meta-Descriptions generieren, die technische Attribute, Alleinstellungsmerkmale und lokale Suchintention kombinieren. GPT-4 verarbeitet mehrstufige Anweisungen („Extrahiere aus dem EAN-Code die Produktkategorie, prüfe ob Sonderangebot vorliegt, formuliere eine Meta-Description mit maximal 155 Zeichen unter Berücksichtigung der Top-3-Keywords aus der Produktbeschreibung“) und liefert in 85–90 % der Fälle direkt verwendbare Ergebnisse. GPT-3.5 Turbo schafft dieselbe Aufgabe mit 60–70 % Trefferquote, die restlichen 30–40 % landen auf Ihrem Schreibtisch. Bei 1.200 Artikeln rechnet sich das so: GPT-4 kostet rund 180–220 EUR API-Gebühren plus 4–6 Stunden Qualitätskontrolle. GPT-3.5 Turbo kostet 40–60 EUR API-Gebühren plus 15–20 Stunden Nachbearbeitung. Bei einem internen Stundensatz von 50 EUR ist GPT-4 hier die günstigere Lösung, trotz höherer Token-Kosten.
Das nehmen Sie jetzt mit
Sie haben die Fakten auf dem Tisch: Die OpenAI API ist für kleine und mittlere Unternehmen technisch erreichbar, wirtschaftlich vertretbar und in vorhandene Systeme zu integrieren, vorausgesetzt, Sie setzen die richtigen Schwerpunkte. Starten Sie mit einem eng definierten Pilotprojekt. Automatisieren Sie eine Routine, die heute noch von Hand läuft: Produktbeschreibungen. E-Mail-Klassifikation. FAQ-Antworten. Setzen Sie sofort ein monatliches Budget-Limit in der OpenAI-Plattform und dokumentieren Sie jeden Request. Greifen Sie zum kleinsten Modell, das funktioniert, gpt-4o-mini kostet 0,15 USD pro 1 Million Input-Token und deckt 80 Prozent aller typischen KMU-Aufgaben ab. Wer tiefer in die Kostenoptimierung einsteigen möchte, findet alle Hebel in unserem Artikel OpenAI API Kosten senken.
Sicherheit und Datenschutz sind keine Nachgedanken. Prüfen Sie vor dem Start genau: Welche Daten landen in der API? Personenbezogene Informationen, Namen, E-Mail-Adressen, Bestellhistorien, dürfen nur mit expliziter Zustimmung und einem dokumentierten Auftragsverarbeitungsvertrag übertragen werden. OpenAI stellt seit einen AVV für Business-Kunden bereit. Nutzen Sie ihn. Verschlüsseln Sie alle API-Calls mit TLS 1.3, lagern Sie API-Keys niemals im Frontend-Code ein und wechseln Sie sie alle 90 Tage. Ein schlanker Webhook-Workflow in n8n oder Make filtert Anfragen vor, bevor sie die API erreichen. Das spart Geld. Und reduziert das Risiko.
Die Kosten bleiben im Griff, wenn Sie drei Regeln befolgen. Erstens: Cachen Sie wiederkehrende Anfragen lokal statt sie ständig neu zu generieren, Standard-FAQ-Antworten sind dafür ideal. Zweitens: Begrenzen Sie die Token-Länge pro Request. 500 Token Output reichen für die meisten Produktbeschreibungen. 2.000 Token kosten Sie bei gpt-4o schon 0,03 USD pro Anfrage. Drittens: Nutzen Sie Batch-Verarbeitung für nicht-zeitkritische Aufgaben. Nächtliche Kategorisierung von Support-Tickets zum Beispiel. OpenAI bietet dafür 50 Prozent Rabatt gegenüber Echtzeit-Requests. Ein realistisches Startbudget für ein KMU mit 200–500 API-Calls pro Monat liegt bei 30–80 EUR. Das ist deutlich weniger, als ein Teilzeit-Mitarbeiter für dieselbe Arbeit kostet.
Bot-Agent Katalog: 25 KI-Automationen
einmaligem Setup, Verkauf noch nicht geöffnet).
Katalog ansehen →Häufig gestellte Fragen
Welche Voraussetzungen muss ich erfüllen, um ein Geschäftskonto zu eröffnen?
Welche Gebühren fallen bei einem Geschäftskonto an?
Kann ich mit einem Geschäftskonto auch online Banking nutzen?
Wie lange dauert die Eröffnung eines Geschäftskontos?
Welche Unterschiede gibt es zwischen einem Geschäftskonto und einem Privatkonto?